Analyse de l’Innovation de Groq : Le Cap des 1250 Tokens par Seconde
la société Groq a franchi une étape historique dans le secteur de l’infrastructure de l’intelligence artificielle en stabilisant une vitesse d’inférence de 1250 tokens par seconde. Cette performance, reposant sur l’architecture propriétaire LPU (Language Processing Unit), surpasse les capacités des GPU traditionnels et redéfinit les standards de latence et d’efficacité énergétique. Cette avancée permet une analyse de données massive en temps réel, l’émergence d’agents autonomes dotés de raisonnements complexes instantanés et impose une pression concurrentielle majeure aux fournisseurs de cloud et aux fabricants de puces comme NVIDIA.
Analyse des Performances Techniques
L’annonce de Groq marque une rupture avec l’hégémonie technologique actuelle en transformant radicalement la vitesse de traitement des modèles de langage (LLM).
Latence et Rapidité de Traitement
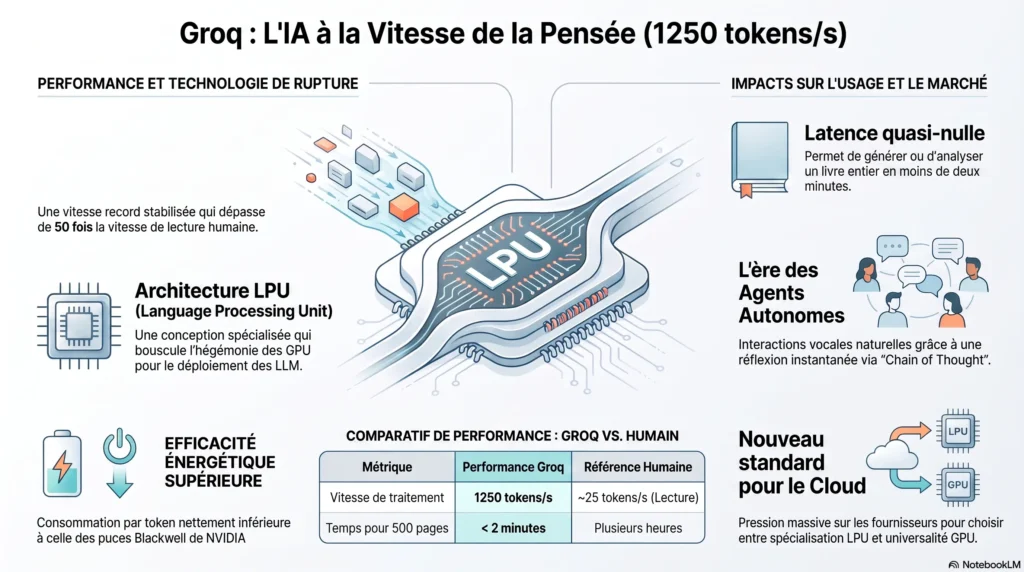
L’atteinte du seuil de 1250 tokens par seconde réduit la latence à un niveau quasi nul, offrant des capacités de traitement sans précédent :
- Vitesse de génération : Un ouvrage de 500 pages peut désormais être généré ou analysé en moins de deux minutes.
- Comparaison humaine : Cette vitesse d’inférence est plus de 50 fois supérieure à la vitesse de lecture moyenne d’un être humain.
- Instantanéité : Pour l’utilisateur final, la réponse de l’IA est perçue comme immédiate.
L’Architecture LPU (Language Processing Unit)
Contrairement aux architectures GPU (Graphics Processing Unit) conçues initialement pour le graphisme, le LPU de Groq est une architecture spécialisée pour le traitement du langage. Cette spécialisation extrême est la clé de la stabilisation de ces records de vitesse sur les modèles de dernière génération.
Nouvelles Capacités Fonctionnelles
La vitesse de 1250 tokens par seconde ne se limite pas à une simple amélioration incrémentale ; elle débloque de nouveaux usages pour l’intelligence artificielle.
Agents Autonomes et « Chain of Thought »
La rapidité de calcul permet désormais le déploiement massif d’agents d’IA capables de :
- Exécuter des chaînes de pensée complexes (Chain of Thought) en une fraction de seconde.
- « Réfléchir » et structurer un raisonnement approfondi sans dégrader l’expérience utilisateur par des temps d’attente.
Interactions Vocales Naturelles
L’absence de temps de pause entre la requête et la réponse rend les interactions vocales totalement fluides. Cette technologie permet d’atteindre un niveau de naturel jusqu’ici entravé par les délais de latence des serveurs traditionnels.
Efficacité Énergétique et Coûts Opérationnels
Un aspect critique de l’architecture LPU réside dans son optimisation énergétique face aux solutions de pointe actuelles.
| Paramètre | Architecture Groq LPU | NVIDIA Blackwell (Référence) |
| Vitesse d’inférence | 1250 tokens/seconde | Inférieure (selon les données de contexte) |
| Consommation électrique | Nettement inférieure par token | Supérieure par token |
| Positionnement coût | Réduction des coûts opérationnels à grande échelle | Standard industriel actuel |
Groq parvient à maintenir une vitesse record tout en consommant moins d’électricité par token généré, ce qui redéfinit l’économie de l’IA à grande échelle.
Impact Stratégique sur le Marché
L’évolution de Groq, passant d’une solution alternative à un standard de fait pour le déploiement en temps réel, modifie la dynamique du marché de l’IA.
- Pression sur les fournisseurs de Cloud : Les acteurs du cloud computing font face à un dilemme stratégique. Ils doivent désormais arbitrer entre :
- L’universalité des GPU : Polyvalents mais moins performants pour l’inférence linguistique pure.
- La spécialisation des LPU : Indispensables pour rester compétitifs sur le segment des LLM en temps réel.
- Concurrence avec NVIDIA : En surpassant les performances énergétiques et de vitesse des puces Blackwell, Groq se positionne comme le leader de l’efficacité pour le déploiement massif de modèles de langage.
Share this content:
Laisser un commentaire